AI 模型競爭一談到「兆級參數」,很容易讓人把數字大小當成能力排名。月之暗面的 Kimi K3 就是一個例子:先前媒體以接近 3 兆的規模描述它,官方公布的數字則是 2.8 兆參數。這款模型已在今年 7 月發表,本文回看的是 K3 的規格與選型意義,不是把它當成今天才推出的新模型。
根據月之暗面官方公告,K3 支援原生視覺與百萬 token 上下文,主打程式開發、知識工作和推理。這些規格說明產品的設計方向;至於能否替使用者少改幾次程式、準確讀完一批資料,仍要看實際任務。
大模型,未必是每個工作的第一選擇
參數可以理解為模型訓練後保存的數值設定,總量是描述規模的一種方式。模型架構、資料品質、推論方式與工具配合,也會影響結果,因此不能只拿參數數量推算品質、速度或使用價格。
一家電商若只是每天整理客服留言,重點可能是分類穩定、回應及時,以及能否接進既有系統。軟體團隊要修跨越多個檔案的問題,才更需要觀察模型理解專案、修改程式和通過測試的能力。兩種工作不必得到同一個選型答案。
百萬 token 上下文也需要這樣解讀:可以放進更多資料,並不保證模型會注意每個細節。文件裡的舊版本、重複內容與互相矛盾的指示,依然可能讓回答失準。先把資料整理清楚,往往比一次塞入所有檔案更有用。
用自己的案例,替規格表補上答案
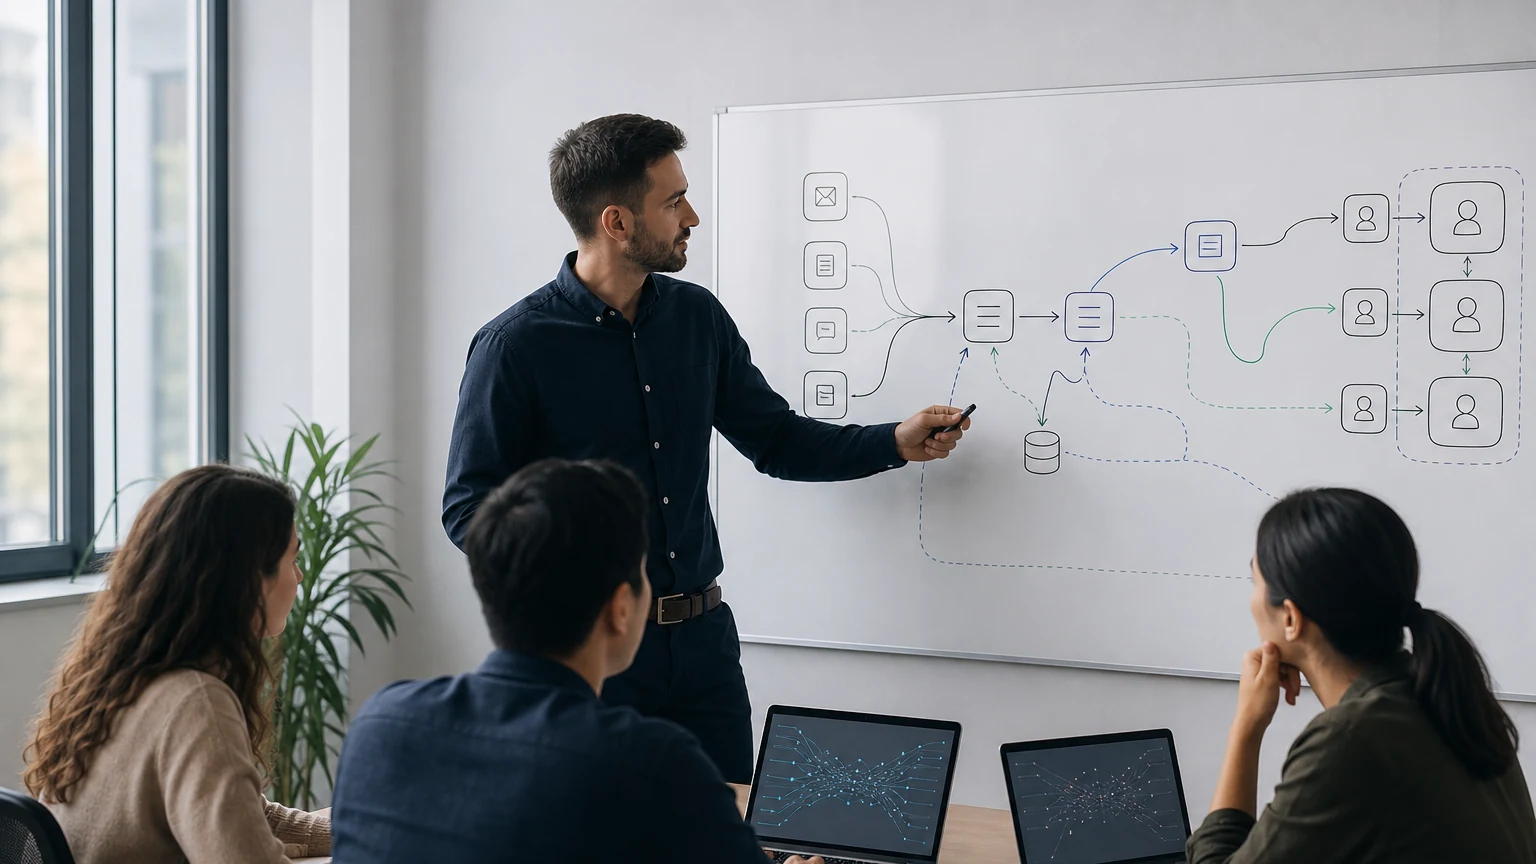
團隊可以挑出十個最近真的做過的工作,把輸入、交付要求和判定標準固定下來。例如程式修改要跑過哪些測試、摘要必須保留哪些數字、回答需要指出哪一段來源。再用候選模型處理同一批資料,記錄完成率、等待時間與人工修正時間。
這些是本文提出的評估方法,不是 K3 的實測成績。若某個模型第一次回答漂亮,卻總要花半小時收尾,它的實際成本可能比訂價看起來更高。涉及內部資料時,還要先確認方案的資料處理條件和可提供的權限。
K3 的規模值得關注,也讓模型競爭進入更大的量級。但選型的決定點,仍是它能否在你的限制下穩定完成工作。把一次完整任務的時間與費用算清楚,才知道大模型究竟省下了什麼。